在图文配对训练中,描述是模型学习文字与视觉内容对应关系的条件之一。若画面只是“侧身持书”,标注却写成“伤心地离开”,这条配对就混进了画面没有证实的内容。问题不在文笔,而在对应关系。
先试着回答右侧四道题。示例答案可以修改,切换题目时,左侧会圈出对应画面。这里刻意保留“未知”:标注员能指出证据不足,比替素材补完一个故事更有用。
DATA NOTES / 从画面到数据
用一个拿书的小动作,练习怎么写标注、怎么清洗素材,以及哪些判断必须回到原片。
01 / 九宫格案例
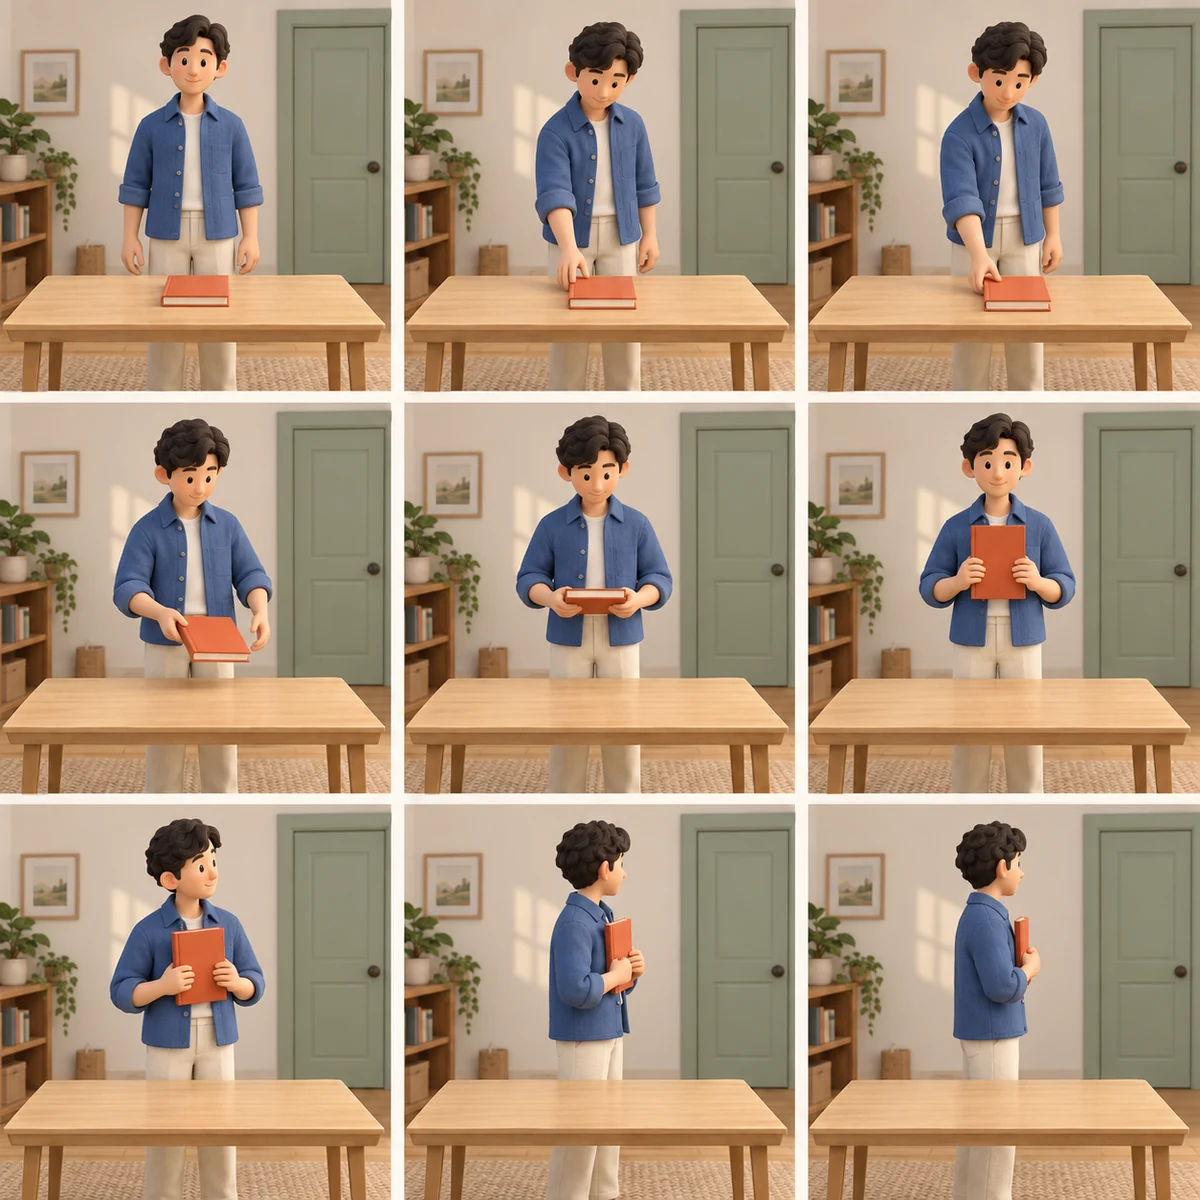
数据标注,就是给素材补上与任务有关的信息。 这次先做最容易上手的一种:把画面中可见的人、物和状态变化,写成能逐项核对的描述。
标注题 01 / 04
先记反复出现、能够辨认的东西。称呼保持一致,不替人物补身份或职业。
这道题在检查什么这组图支持颜色、衣着和物体类别,不能证明人物是学生、作家或书店店员。
在图文配对训练中,描述是模型学习文字与视觉内容对应关系的条件之一。若画面只是“侧身持书”,标注却写成“伤心地离开”,这条配对就混进了画面没有证实的内容。问题不在文笔,而在对应关系。
先试着回答右侧四道题。示例答案可以修改,切换题目时,左侧会圈出对应画面。这里刻意保留“未知”:标注员能指出证据不足,比替素材补完一个故事更有用。
02 / 描述写到哪
Caption 是对素材内容的文字描述。 它的细致程度由训练任务决定;本例先写清“谁、做了什么、物体怎样变化”,再检查有没有写进看不见的剧情。
年轻作家伤心地拿起日记,缓慢走出房间。
职业、情绪、书的用途、速度与出门结果,都缺少足够画面依据。
蓝色衬衫人物将橘红色书从木桌上拿起,竖着拿在胸前,随后侧身持书。
从书在桌上,到书离桌、竖持、侧身:每个状态都能找到对应格子。
同样一段视频,训练目标不同,需要的标注也不同。若要学“拿起”的动作,接触、离桌和握持变化就很关键;若要学书的外观,封面、形状和遮挡可能更重要。先写一页标注规范,再开始批量干活。
这页规范至少约定四件事:物体怎么命名、标注做到多细、看不清时怎么记、什么情况必须复核。比如把“书”和“日记”混着用,看似只是换了个词,其实给物体增加了未经确认的用途。
03 / 清洗怎么做
数据清洗,是发现并处理不适合当前任务的样本。 有的需要剔除,有的只需修正描述;有的看起来重复,却保留了重要变化。
检查解码、断尾、黑帧、尺寸和时间信息。真实视频还要看切镜是否把一个动作截断。
若动作被截断,回到原片调整边界;解码失败等问题无法修复时再剔除。保留原文件与处理记录。
同一文件的重复副本,可用哈希查找;重新压缩、裁切后的近似内容,需要相似检索与人工核对。[2]
02、03 很像,但接触细节值得复核。对动作任务,不要仅凭相似分数删除关键状态。
查看手物接触、异常形变、遮挡、字幕遮盖和运动模糊。真实片段要连续播放,不能只看封面。
若书始终被字幕挡住,不适合用来学习书的外观。若目标包含遮挡场景,有遮挡的素材可能正需要保留。
同一动作被写成“放下”;人物只是转身,却被写成“出门”。自动生成的描述也要检查。
本例把“走出房间”改成“侧身持书”。若原片也看不清,就标成未知或待复核,不强行凑答案。
不要只记录“删了多少”,还要记录“为什么处理”。 样本编号、原始来源、处理方式、原因与版本,至少应当连得起来。
OpenVid-1M 的数据流程把清晰度、时序一致性、运动等分开检查,提醒我们不要只看单帧漂亮不漂亮。但它的筛选取舍服务于它的训练目标,不能直接变成所有项目的统一标准。[5]
如果目标是快速运动或静物镜头,就不能套用一条“太快或不动都删掉”的规则。清洗之前先问:这条素材到底会教给模型什么?这个答案决定了应当保留的变化。
04 / 别让数据泄漏
训练集用于学习,验证集用于检查与选择方案。 如果两边装着同一段视频的相邻片段,这道检查题可能过于熟悉,难以反映模型面对新素材的表现。
✕ 同一段素材拆到两边
只换片段编号,角色、背景甚至相邻画面可能几乎一样。验证结果容易过于乐观。
✓ 先按来源分组,再做切分
假设 A、B 来源独立,且没有重复内容。先分组,后抽帧,减少相邻画面跨集合的问题。
可以先给原视频分配来源 ID,再让它的抽帧、裁切和重编码版本继承同一组。切分时按组分配,而不是把所有帧打散抽签。 这是把分组验证的方法应用到视频资料,能减少相关素材跨集合的问题。[3]
只按文件分组仍可能不够:两份下载文件可能来自同一镜头。要先查重复来源;若目标是验证新人物或新场景,还要在相应层级做隔离。验证集也会参与方案选择,最终评测还应留出不参与调参的测试集。
同一片段,分别写主体、动作与未知项。先不互看答案,才能发现规则有没有说清。
有人写“拿起”,有人写“翻书”?一起回看接触与书本朝向,找出究竟是哪一帧支持判断。
把边界样例加入规范,记录新版本。若规则改变,检索受影响的旧样本,一并复核。
图片、描述和来源要能对得上。下面是本案例的最小记录,也可以下载成 JSON,继续补充字段。
包含右侧四道题的当前答案;刷新页面会恢复示例。
这是字段设计示例。接入训练前,应按所用工具转换格式;它不是可直接训练的视频数据包。
图片与文字怎样对应,Hugging Face 的 ImageFolder 给了一个直观例子:用元数据中的 file_name 指向图片,再为它附上文本。存储方式可以很简单,但它只解决“对上文件”,不会替你保证“写对内容”。[1]
真实项目还应补齐原片路径或来源、片段起止时间、标注人、复核人和清洗原因。右侧示例特意把真实时间码留空:没有的信息,留空并解释,比填一个看起来完整的数字更可靠。
06 / 最后记住
这九张图里,最值得认真做的,是区分“看见了什么”和“还不知道什么”。人物侧身,不等于已经出门;两个姿态相近,不等于其中一个毫无价值;一句描述流畅,也不等于它与画面对得上。
准备训练数据时,我更在意三个问题:这条描述有画面依据吗?这份素材适合当前目标吗?别人能沿着记录复查我的判断吗? 把这三件事做扎实,后续出现问题时,才知道应该补素材、改标注,还是调整训练方案。