项目分析
爆款视频案例
- 在海外短视频平台 TikTok、Instagram Reels 上,拟人化萌宠短视频持续形成大规模传播浪潮。以举例中三猫齐舞、半夜扰民音乐猫、新品皇室小猫发布会为代表的内容,凭借萌宠本体和人类行为的强烈反差,获得千万级播放与大量转发分享。
视频 | 内容与传播记录 |
|---|---|
视频 01|三猫齐舞 视频下载原视频 ↓ | 小小的身体,跳得非常认真。 三只幼猫排成队形同步跳舞,圆脸、短肢与专业动作形成反差。它把“可爱”变成了一个容易记住、模仿和改编的动作梗。 7,950 万以上播放 · 约 790 万赞(2026 年 7 月) 作者:@meowtakeover · 原帖 |
视频 02|半夜扰民音乐猫 视频下载原视频 ↓ | 乐器被收走,猫换一件继续。 猫的坚持和主人的无奈形成来回较量。观众既想看它下一次拿出什么,也容易联想到“我家那只就是这样”。 约 125 万播放 · 18.4 万赞 · 9.4 万分享(2026 年 9 月) 作者:@soratop11 · 原帖 |
视频 03|新品皇室小猫发布会 视频下载原视频 ↓ | 像发布一件电子新品一样介绍猫。 细节特写、悬浮展示和整齐阵列,把熟悉的发布会语言用在宠物身上。认真展示的姿态,放大了“这只猫值得被隆重介绍”的喜感。 10.2 万播放 · 9,207 赞 · 1,811 次分享(2026 年 9 月) |
洞察与分析
内容演变point:记录真实瞬间 → 用后期赋予性格 → 用 AI 安排表演
- 在 AIGC 技术普及之前,想要产出这类拟人向萌宠内容,生产门槛很高。内容大多依赖实拍素材剪辑+后期特效/者手工动画完成。普通养宠用户只能作为内容的观看者,很难把自家宠物制作成同类短片,优质内容集中在少数专业创作者手中,内容的规模化扩散受限于生产能力。
- 随着图生视频 AIGC 技术不断迭代,角色身份保留、短叙事画面生成能力逐步成熟。过去只有专业团队才能实现的萌宠拟人鬼畜短剧,现在可以下沉为普通用户即可使用的 AI 能力。
- 技术降低了创作门槛,放大了内容的生产主体,进一步放大了该类内容的传播势能,同时也诞生了新的产品效果设计机会。
记录真实瞬间 | 用后期赋予性格 | 用 AI 安排表演 |
|---|---|---|
2008|Maru 钻纸盒 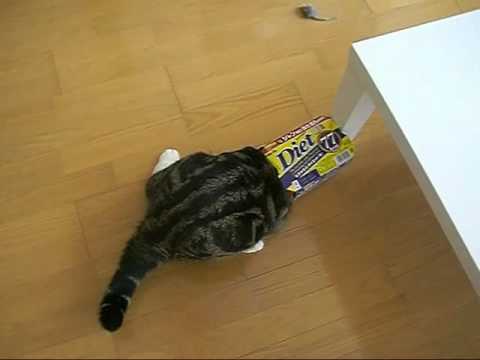 拍下猫钻进小纸盒的真实动作。习性与体形的反差让人发笑,分享像把生活中的趣事讲给朋友。 mugumogu · 原视频 | 2011|给狗配上人声 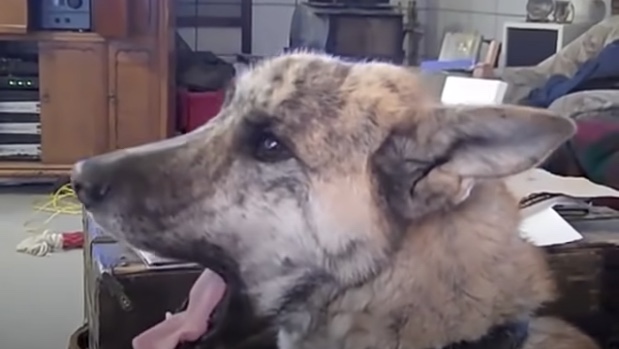 《Ultimate Dog Tease》用配音把张嘴、转头解读成期待与失落。动物有了人的内心戏,观众能拿它表达自己的情绪。 Talking Animals · 原视频 | 2026|让猫开一场发布会 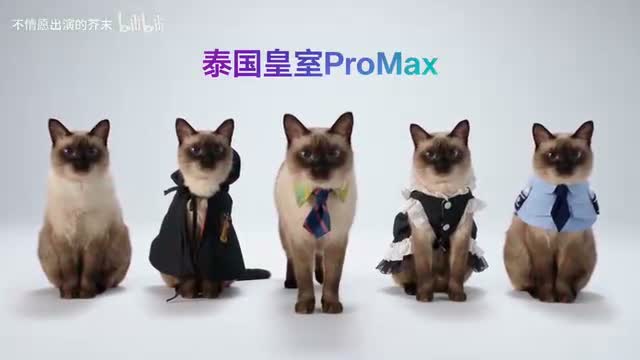 造型、阵列与镜头围绕“新品发布”编排。观众看的是熟悉宠物的新表演,也会好奇“换成我家的是什么样”。 不情愿出演的芥末 · 原视频 |
这些做法今天仍在并存。变化是作者能决定的内容越来越多:从捕捉一个瞬间,到赋予性格,再到安排角色、动作和整段故事。
- 越做越精良,重点是把设定演清楚:角色、动作、节奏、镜头、声音与剪辑,让“猫能这样动”成为“这只猫在做一件有趣的事”。
|观看、分享、制作:各自想得到什么?
视角 | 踩中的情绪与动机 | 设计时抓住什么 |
|---|---|---|
观众|为什么看 | 可爱带来轻松;宠物做出人的动作,带来意外;连续回应让人想看下一步。 | 第一眼看清角色和异常;像音乐猫一样,让每次动作都带来新的结果。 |
分享者|发给谁 | “太可爱了”“这就是我家那只”“这不就是我们”。分享快乐,也借视频表达关系。 | 笑点一句话能复述;保留熟悉的生活细节,让人自然想到某位朋友。 |
宠物主人|为什么做 | “我的宠物也能这样吗?”用有趣的方式晒自己的宠物,获得朋友的回应。 | 保留脸、毛色与神态;玩法能容纳不同宠物的性格,而不只展示统一造型。 |
持续创作者|为什么继续 | 表达幽默和审美;观众对角色、动作的回应,提供下一条作品的题材。 | 形成能被认出的角色与风格;从评论中找新关系、新情境,延续观众期待。 |
可爱让人愿意看,反差让人记住,代入让人想到要发给谁。“换成我家的会怎样”,把欣赏一条作品推进到亲手制作一条。
- 传播与创作的循环:作品进入推荐流 → 有人转给朋友、评论接梗 → 有人尝试换入自家宠物 → 作者从回应中找到下一条题材 → 再次发布。
|目前优缺点及改进方向
优点
- 情绪门槛低,易实现破圈传播
- 充分满足用户的人格投射心理
- 玩法上手简单
- 可复用性强
不足
- 同质化严重
- 内容想象力被模板束缚
- 社交话题钩子薄弱
改进方向
- 从固定模板驱动 → 图片信息驱动,提升专属感
- 设计多变酬赏,提升复访动机
- 做好原子能力沉淀,兼顾后续迭代拓展
|Personas
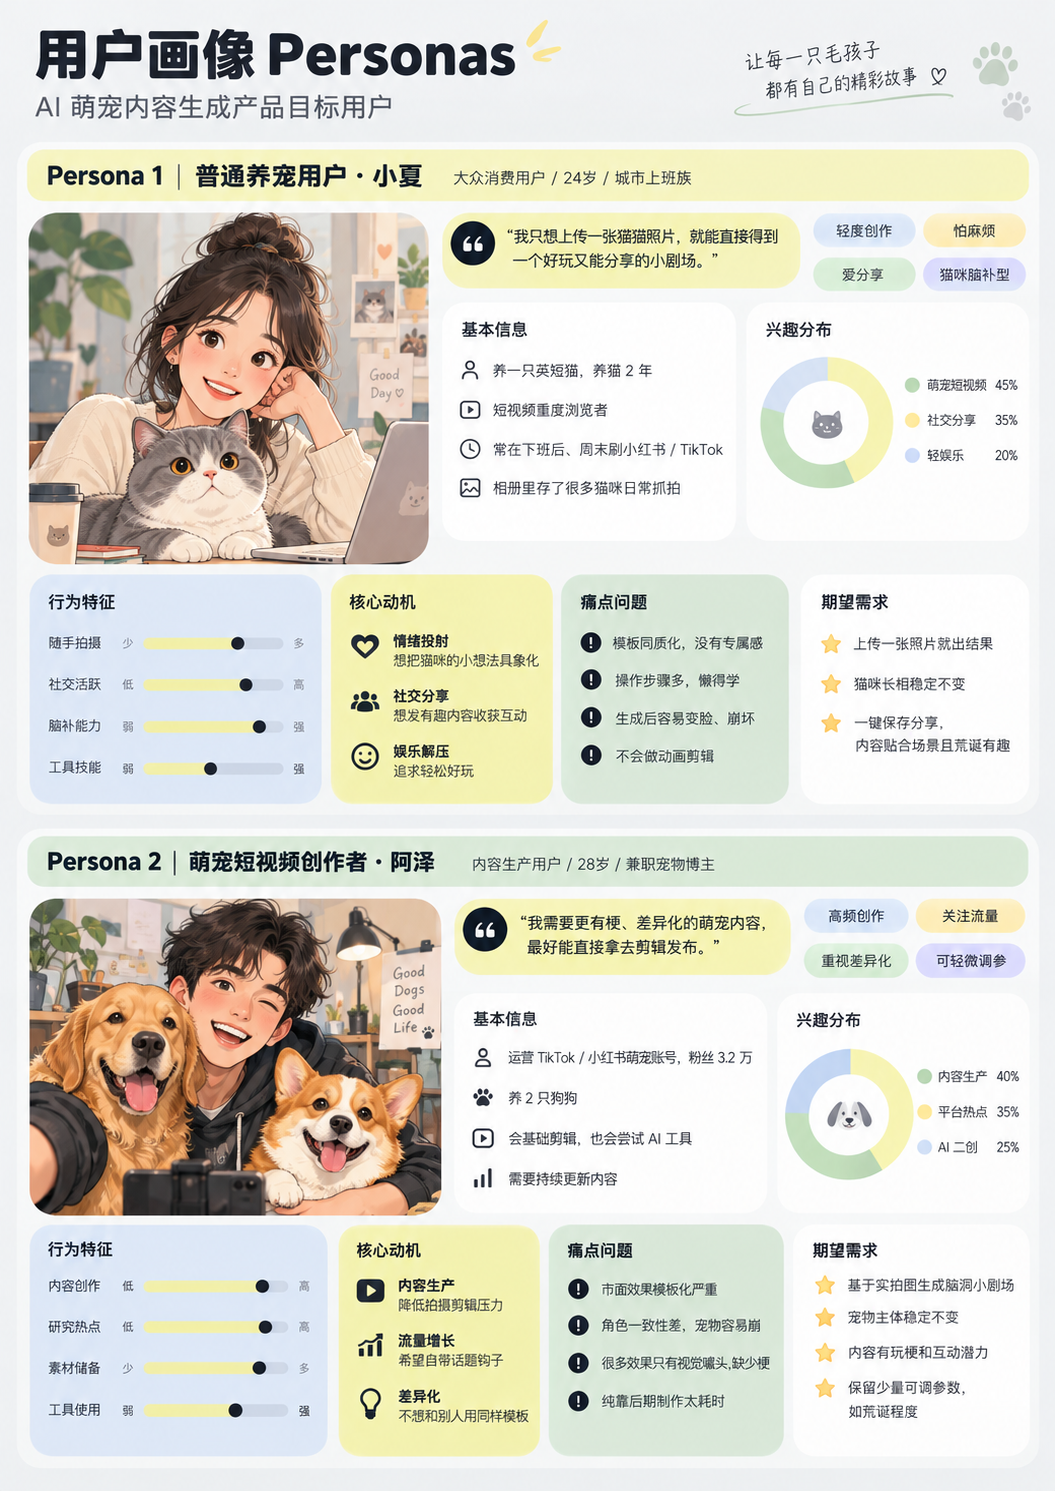
Higgsfield 社区AI效果:这些吸引力怎样变成画面
社区视频 | Hook Model 分析 |
|---|---|
社区 01|小狗魔法变身 视频下载原视频 ↓ | 触发 美少女战士式变身唤起熟悉的老动漫记忆;毛爪、肉垫与魔法装扮叠加可爱感,让宠物主人想到“它也能拥有一次主角登场”。 行动 观看只需停留,制作则要找到同款、提供宠物照片;照片能否保住身份,决定期待能否兑现。 酬赏 逐件变装让人等完整亮相;个人化回报是“还是我家那只,却从没这样登场”。同一段揭晓不自动构成第二次制作的理由。 投入 主人挑选照片、命名角色,可形成自己的宠物形象。若能沿用这个形象进入另一段登场,首次投入才帮助下一次;保存与复用目前未由原片证实。 |
社区 02|林间小狗运镜 视频下载原视频 ↓ | 触发 把人像短视频中熟悉的贴脸、拉远与环绕运镜交给小狗;快速位移与短停形成节奏,让日常宠物获得明星待遇。 行动 主人想选一张最像自家性格的照片,看看同一套镜头拍出来是什么气场。实际选择与生成步数待操作页核验。 酬赏 回报持续发生在每次停顿的肖像中。毛色、脸形与神态改变气质,但同一只宠物重复同一运镜,新增回报可能很快减弱。 投入 可积累的是满意的宠物身份和“这次想拍什么”的审美偏好。后续需要新的拍摄情境;仅多转一圈镜头,未必形成值得回来的目标。 |
社区 03|一猫跳舞,一猫拍 视频下载原视频 ↓ | 触发 短腿猫认真跳人的舞,另一只猫举手机跟拍;魔性动作让人停留,“我跳、你拍”的关系让人想到具体朋友。 行动 看完可以先发给朋友;主人还可能尝试把自家宠物放入舞者位置。两只猫同框本身不能证明支持双图替换。 酬赏 观看得到身体反差,制作得到“我家正经脸跳这一段”的个人化喜感,分享又可能收到朋友接梗。这些回报发生在不同阶段。 投入 选定角色、给双方配一句私人的说明,增加关系含义。朋友若回应“换我来拍”,便出现下一条的题材;这是可设计的回访触发,而非原片已证明的留存。 |
社区 04|小狗走进汪汪方阵 视频下载原视频 ↓ | 触发 GENER8ION《STORM》的阶梯群舞换成小狗:识梗者认出MV改写,不识梗者也能读懂“这只小狗是全场主角”。 行动 制作欲集中在中心位置:把自己的宠物换进去,就能参与这段文化梗,不必从头导演一群角色。 酬赏 观看得到规模与秩序的冲击;制作得到专属的隆重亮相;同好回应带来被理解的满足。群体乱动会破坏回报,并非多变酬赏。 投入 主角形象和作品可以积累,重复使用仍需要新出场、下一段舞步或回应。设计时先保住中心身份,再扩变化,避免角色淹没在视觉规模里。 |
- 四例共同的吸引力,是让熟悉的宠物进入值得观看的表演:变身与运镜满足专属展示,双猫与群舞还提供朋友关系和文化参与。上传自己的宠物,才把“好看”进一步变成“我也想做”。
- 观看、制作、复用是三个不同的问题:一次揭晓可以吸引看完,却不能单独解释同一主人为什么再做;新的表达目标、朋友回应及能复用的宠物形象,是后续设计需要考虑的条件。样片本身不证明平台已有身份保存或留存机制。
AI效果技术分析
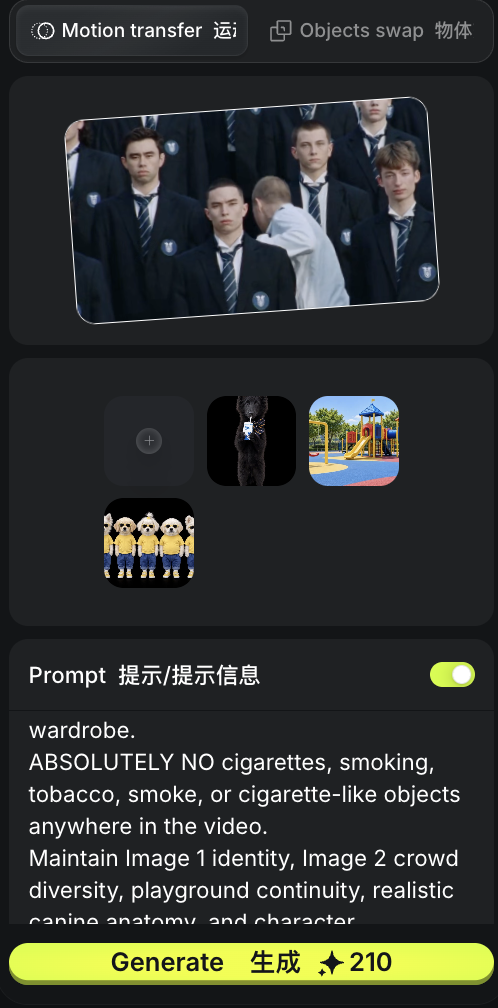
参考编辑界面,用户提供。上方为动作视频,中间为角色与环境图,下方为文字编辑要求。
模型能力 | 可执行操作 | 效果产品化 |
|---|---|---|
视频编辑 | 以参考片为基础替换角色或场景,约束需要保留的动作、镜头和节奏。 | 作者先做好参考片,固定表演与修改范围。 |
参考视频与多模态输入 | 参考视频提供表演;图片指定宠物与环境;文字说明编辑要求。 | 把简短Prompt和图片替换位置预设成效果;用户上传自己的照片调用。 |
|参考视频+角色/环境图+文字要求 → 视频编辑生成 → 个性化同款效果
- 作者预设参考视频、替换位置与简短Prompt,使用者上传自己的宠物图,环境图作为可选输入。通用的视频编辑与多模态能力,由此被封装成输入明确、玩法固定的AI效果。
项目创意方案:毛孩子脑内剧场
|一句话定义
拍一张你家毛孩子的照片,AI替你演出来它此刻正在想什么——10秒荒诞小剧场。
**由即梦平台Seedance2.5 生成
|为什么是这个方向
基于前面的洞察分析,我们发现:
- 宠物主人真正想表达的不是"好可爱",而是"这就是我家那只"——每个宠物主人都认为自己的毛孩子有独特的性格和想法
- 现有AI宠物效果(变身、运镜、走秀)都是统一模板——不管你上传什么猫,出来的都是同一段表演,缺乏"这就是我家那只"的专属感
- "你家毛孩子在想什么"这个问题本身就是钩子——每个养宠的人都会好奇,天然有分享欲
核心情绪核:我家的毛孩子是独一无二的,它有自己的内心戏。
|和现有效果的区别
现有Higgsfield效果 | 毛孩子脑内剧场 | |
|---|---|---|
逻辑 | 上传照片 → 进预设模板 | 上传照片 → AI理解图片 → 生成专属小剧场 |
个性化 | 所有猫跳同一段舞 | 每张照片出来的故事都不一样 |
荒诞感 | 弱(只是换个场景) | 强(根据图片元素生成荒诞剧情) |
分享钩子 | "我家猫也会变身" | "你家猫此刻在想什么?" |
技术路径设计
整体流程
用户上传照片
    ↓
Step 1:多模态图像理解
    ↓
Step 2:图像拆解(主体/环境/道具分离)
    ↓
Step 3:荒诞剧情生成
    ↓
Step 4:视频合成生成
    ↓
10秒荒诞小剧场
|Step 1:多模态图像理解
用户上传一张宠物照片后,首先通过多模态大模型对图片进行全面理解,输出结构化分析结果:
识别内容包括:
维度 | 识别内容 | 示例输出 |
|---|---|---|
主体识别 | 宠物种类、品种、毛色、体型、表情、配饰 | 红棕色短毛猫、黑色胸背带、银色牵引绳、警觉表情 |
环境识别 | 室内/室外、场景类型、背景元素 | 户外草地、大树干背景 |
道具识别 | 图片中出现的关键物体 | 牵引绳、胸背带 |
姿态识别 | 宠物的动作、朝向、互动对象 | 侧头看向左边、身体站立 |
为什么要做这一步?
- 不是简单地把原图直接喂给视频模型
- 而是先让AI"看懂"这张照片里有什么
- 为后续的荒诞剧情生成提供输入依据
|Step 2:图像拆解(分量分离)
将原始照片拆解为三个独立图层,作为后续视频生成的参考图:
图层 | 内容 | 用途 |
|---|---|---|
主体图层 | 只有宠物(猫/狗),背景透明或纯色 | 作为角色一致性参考,保证生成视频里还是这只毛孩子 |
环境图层 | 只有背景环境(草地、树干、房间等),没有宠物 | 作为场景参考,保证环境一致 |
道具图层 | 图片中的关键道具(碗、玩具、牵引绳等) | 作为荒诞剧情的触发元素参考 |
技术实现:
- 主体分离:使用SAM(Segment Anything)或人像/动物分割模型
- 环境还原:基于主体图层反推背景
- 道具识别:多模态模型识别图片中的关键物体
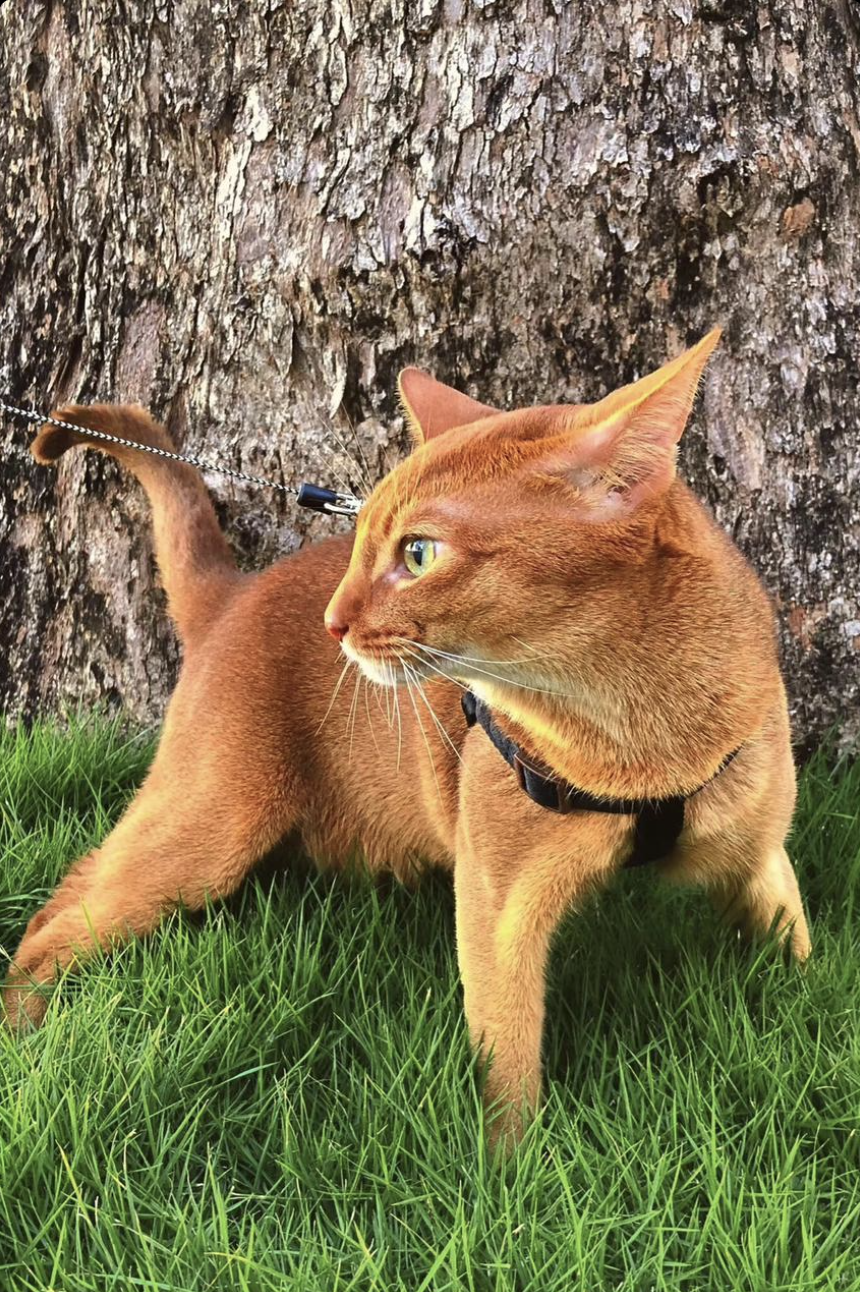
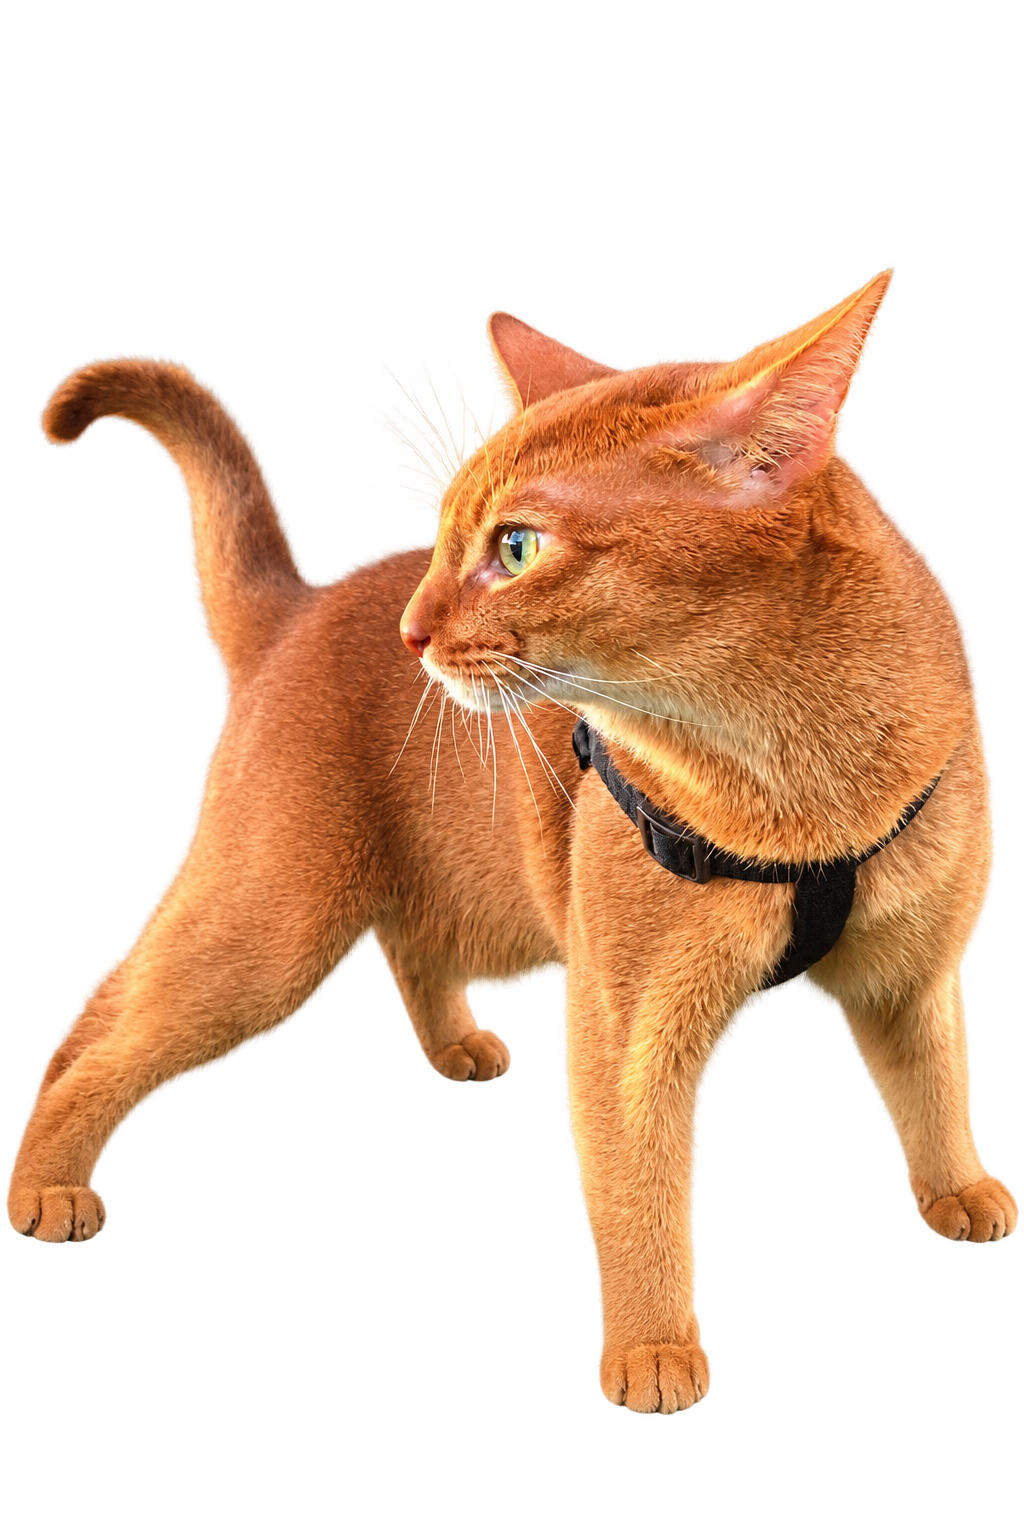
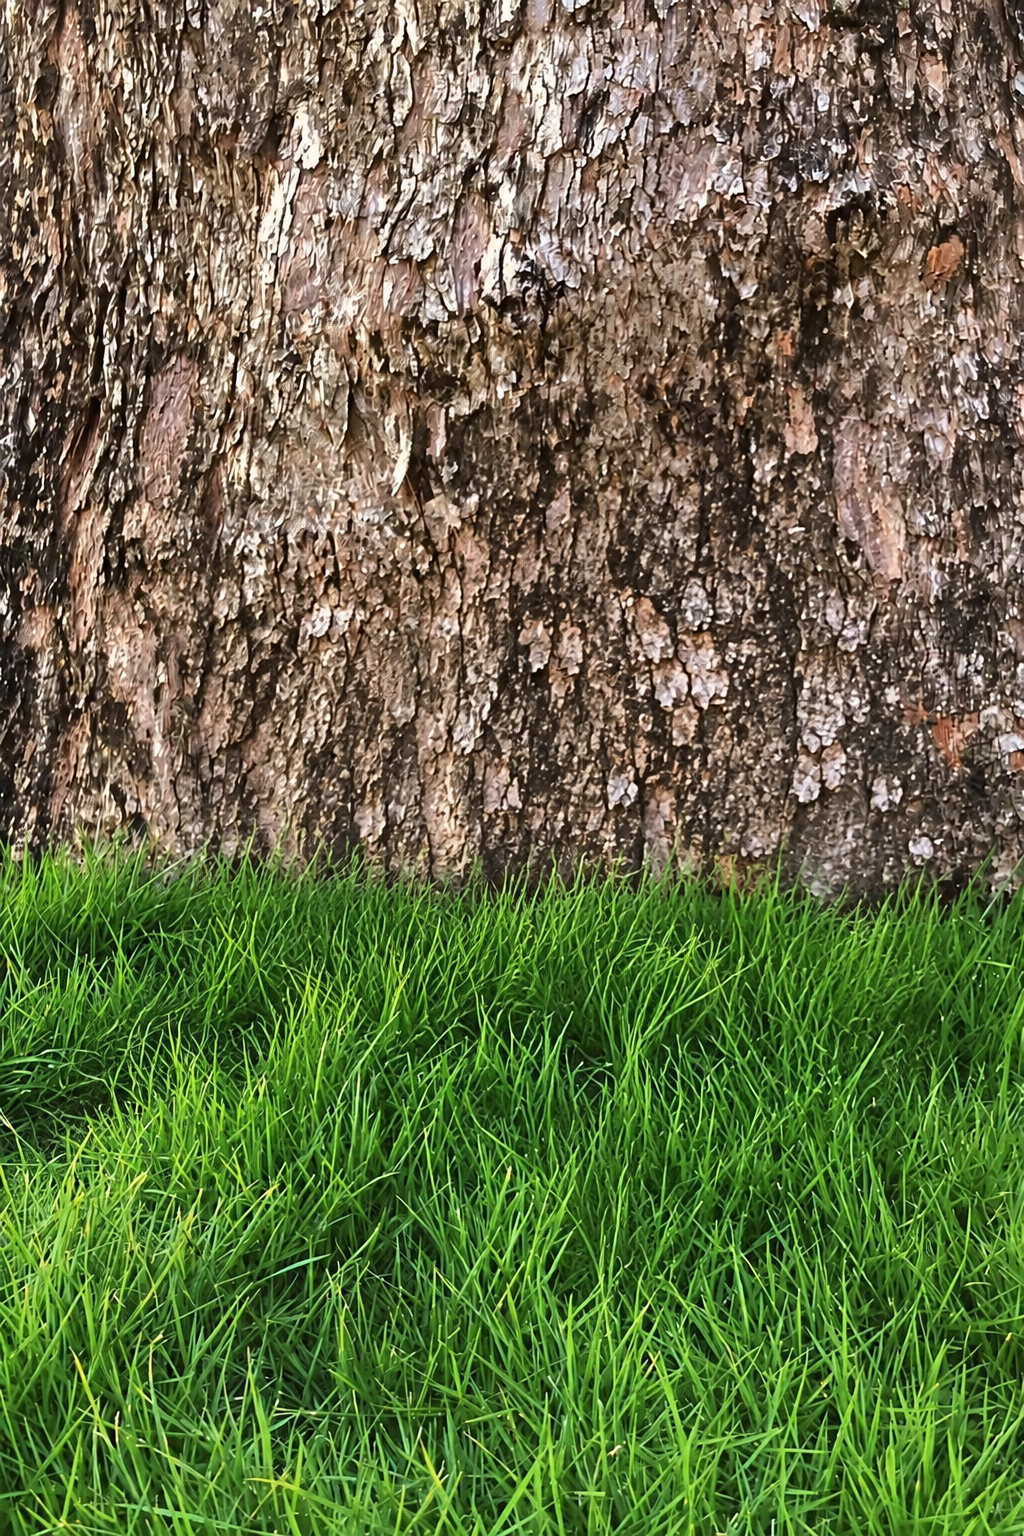
为什么要拆成分量图?
- 可控性更强:分别控制主体、环境、道具,比直接用整张图生成更稳定
- 角色一致性:主体单独作为参考图,生成视频时不容易变脸
- 环境一致性:环境单独作为参考图,场景不会乱变
- 可组合性:后续可以灵活替换/调整某个图层,不用整图重来
|Step 3:荒诞剧情生成
这是整个效果的核心——根据图片分析结果,自动生成一个荒诞小剧场剧本。
设计思路:荒诞规则库
建立一套荒诞规则匹配机制:
规则库结构:
- 每条规则包含:触发条件 + 荒诞剧情模板
- 系统根据Step 1识别到的元素,自动匹配对应的荒诞规则
- 多条规则可以组合,生成更丰富的剧情
规则示例:
触发元素 | 荒诞剧情 | 示例 |
|---|---|---|
牵引绳/胸背带 | 牵引绳反杀——绳子自己动起来遛猫 | 牵引绳像蛇一样自己绷紧,开始拉猫走 |
碗/食物 | 碗自己去找食物 | 猫的碗从地上飘起来,自己去厨房找吃的 |
人 | 体型反转 | 宠物变大,主人变小,反过来遛主人 |
窗户/门 | 门外有东西在看你 | 窗户慢慢自己打开,窗外有一双眼睛在偷看 |
玩具 | 玩具自己跑了 | 猫的玩具突然自己动起来,猫在后面追 |
大树/植物 | 植物活了 | 树干上长出眼睛,和猫对视 |
镜子/反光 | 镜子里的自己动了 | 镜子里的猫做了一个现实中猫没做的动作 |
为什么用规则库而不是自由生成?
- 可控性:自由生成太不可控,可能出来莫名其妙的东西
- 可扩展性:规则库可以不断积累新规则,越用越丰富
- 质量稳定:每条规则都经过验证,保证效果不会翻车
- 用户感知:每张照片触发不同规则,用户觉得"每次都不一样"
|Step 4:视频合成生成
将拆解后的三个图层 + 荒诞剧情prompt,输入到视频生成模型:
输入:
- 主体参考图(保证角色一致)
- 环境参考图(保证场景一致)
- 荒诞剧情描述(描述发生了什么荒诞的事)
输出:
- 10秒竖版视频
- 宠物外观保持一致
- 环境基本保持一致
- 荒诞元素在场景中自然发生
技术要点:
- 使用图生视频模型(如Seedance 2.5等支持多模态参考的视频模型)
- 多参考图输入:主体参考 + 环境参考
- Prompt工程:将荒诞剧情翻译成模型能理解的视觉描述
- 负面提示词:防止宠物变脸、畸形、环境错乱
为什么这个效果能火
|情绪价值
情绪层次 | 对应 |
|---|---|
表层(好玩) | "哈哈这个松果自己动了" |
社交层(炫耀) | "我家猫的内心戏也太多了" |
深层(共鸣) | "对对对,我家那只就是这样的!" |
|传播逻辑
- 用户A拍了一张猫的照片 → 生成了一个荒诞小剧场
- 发到朋友圈/小红书 → 朋友B看到:"这是什么?好有意思!"
- 朋友B点进来 → 上传自己家狗的照片 → 也生成了一个
- 朋友B再发出去 → 形成链式传播
传播钩子: "你家毛孩子此刻在想什么?"——天然的社交话题
|多变酬赏
和Higgsfield的固定模板不同:
- 每张照片出来的荒诞剧情都不一样
- 因为触发的荒诞规则不同
- 用户会反复尝试:"我再换一张照片,看看它又在想什么"
落地策略
|MVP阶段(第一期)
目标:验证核心假设——用户愿不愿意做、做完愿不愿意分享
- 支持单张宠物照片输入
- 荒诞规则库先覆盖5-10条高频规则
- 视频时长5-10秒
- 先支持猫和狗
|第二期
- 扩展荒诞规则库到20+条
- 支持双宠同框(两只宠物一起演小剧场)
- 增加"内心OS字幕"功能
- 支持宠物种类扩展(兔、仓鼠等)
|第三期
- 支持视频输入(不只是照片)
- 荒诞规则UGC化(用户可以投稿新规则)
- 沉淀宠物角色库(用过一次的宠物形象可以保存复用)
- 形成"毛孩子小剧场"系列内容生态
|效果质量标准
维度 | 验收标准 |
|---|---|
角色一致性 | 生成视频里的宠物和输入照片是同一只,毛色、脸形不变 |
环境一致性 | 场景基本保持一致,不会出现环境错乱 |
荒诞感 | 有明显的"不合理但合理"的剧情转折 |
稳定性 | 10次生成中8次不翻车(无畸形、无变脸) |
生成速度 | 用户等待时间不超过30秒 |
Demo制作
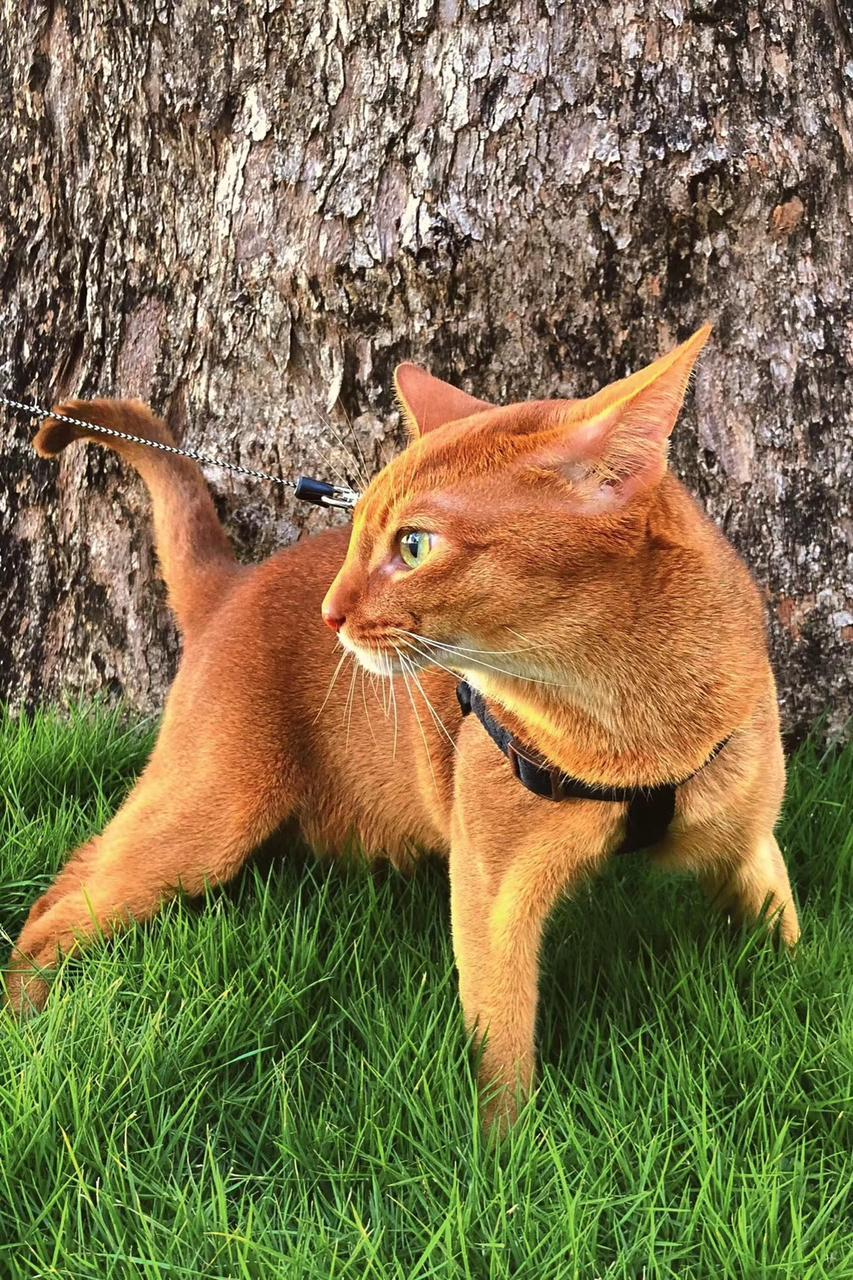
制作思路
基于「毛孩子脑内剧场」的核心创意,选取一张橘猫在树下的照片作为输入,验证"AI理解图片→生成荒诞剧情→输出小剧场视频"的完整链路。
制作流程:
原始照片
    ↓
Step 1:图像拆解(主体 + 环境分离)
    ↓
Step 2:多模态模型生成荒诞剧本 + Prompt
    ↓
Step 3:即梦 Seedance 2.5 样片模式生成视频
    ↓
最终Demo视频
|Step 1:图像拆解
将原始照片拆解为两张参考图:
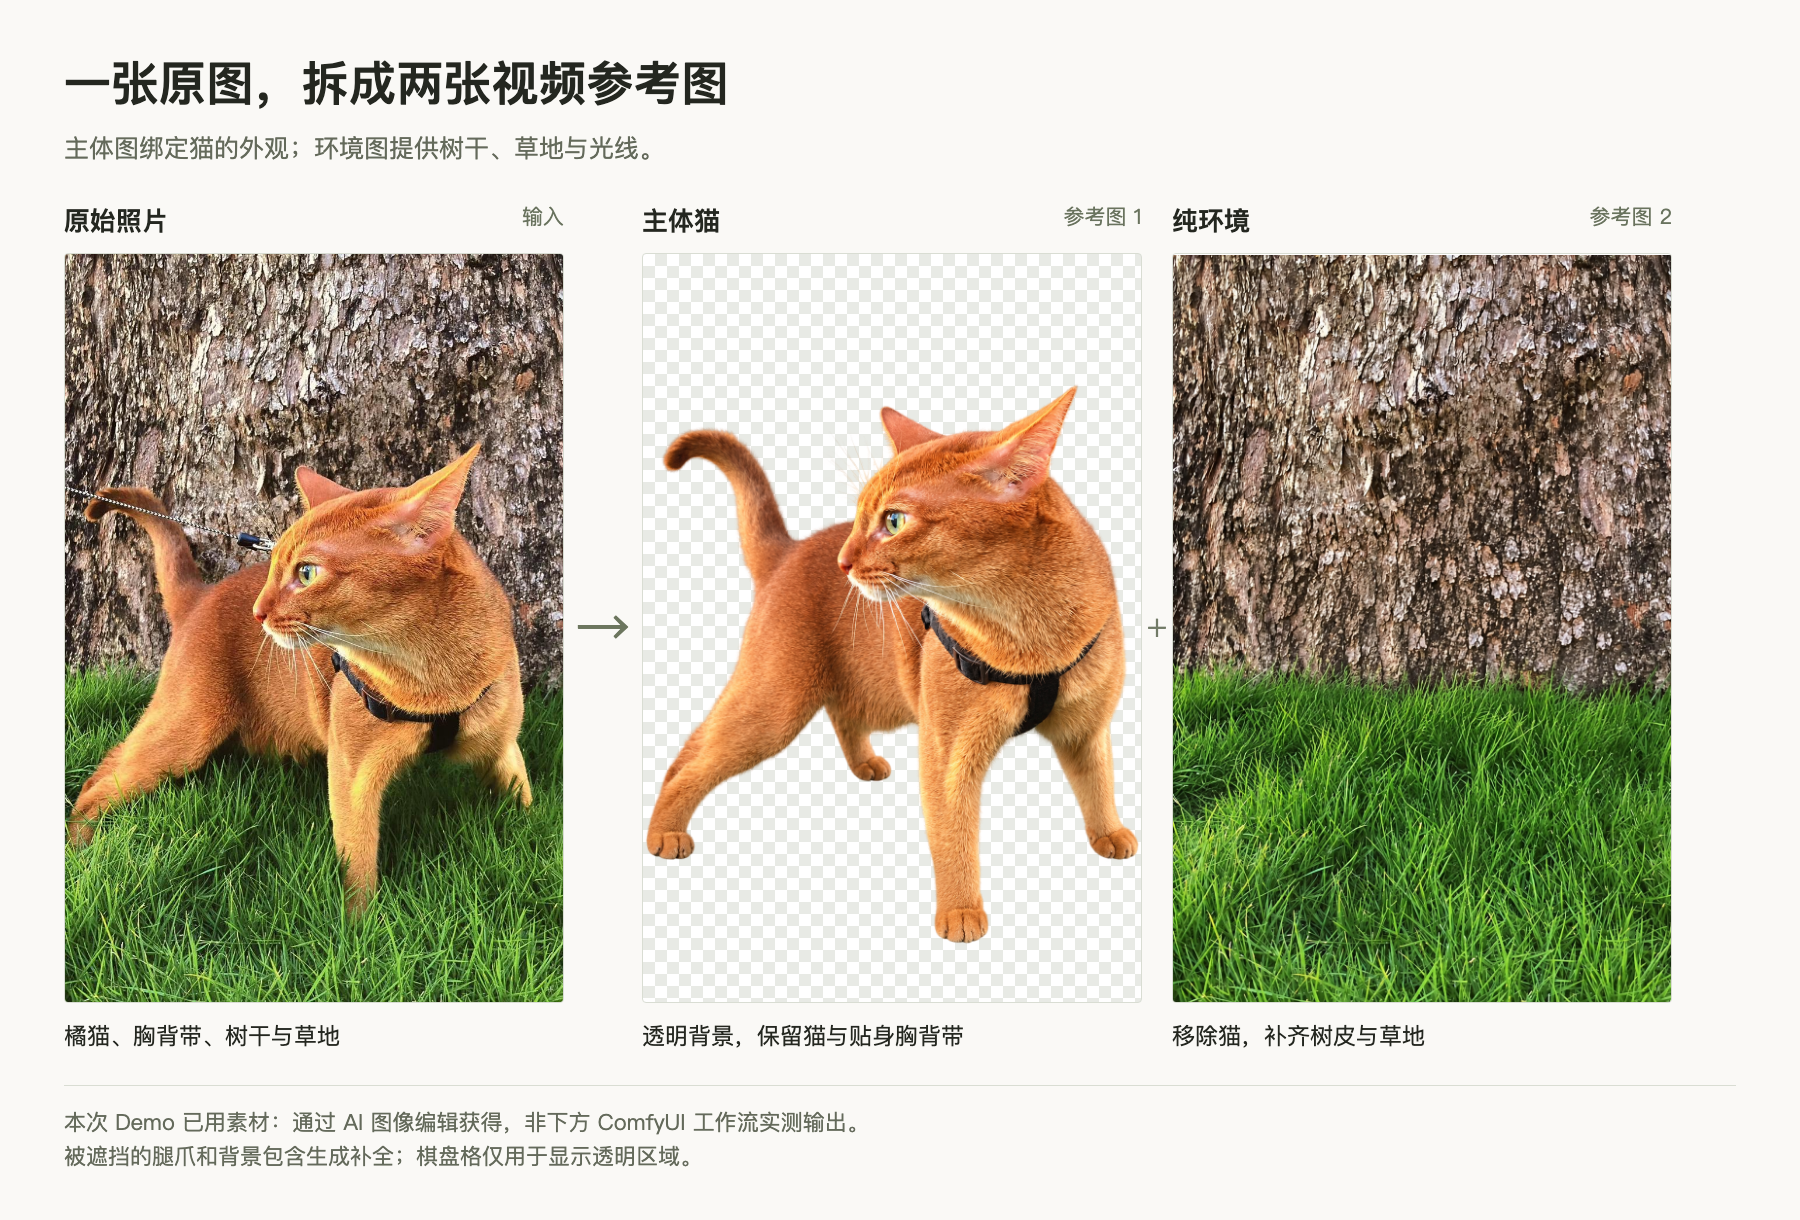
本例素材实际由图像编辑生成:主体图保留橘猫与贴身胸背带,去掉背景和向外延伸的牵引绳;环境图移除猫、胸背带与牵引绳,补齐树皮和草地。下方 ComfyUI 将抠图与补洞整理为可复用的本地流程。
参考图1:主体(猫)
抠出橘猫主体,保留猫的毛色、面部特征、黑色胸背带,作为角色一致性参考。
参考图2:环境(场景)
保留大树干和草地,作为场景一致性参考。
本地拆解管线:复用现成节点,将“宠物抠图”和“背景补洞”分开处理。下图为真实 ComfyUI 导入画布;节点与连线已核验,模型权重待配置,尚未对原图运行推理。
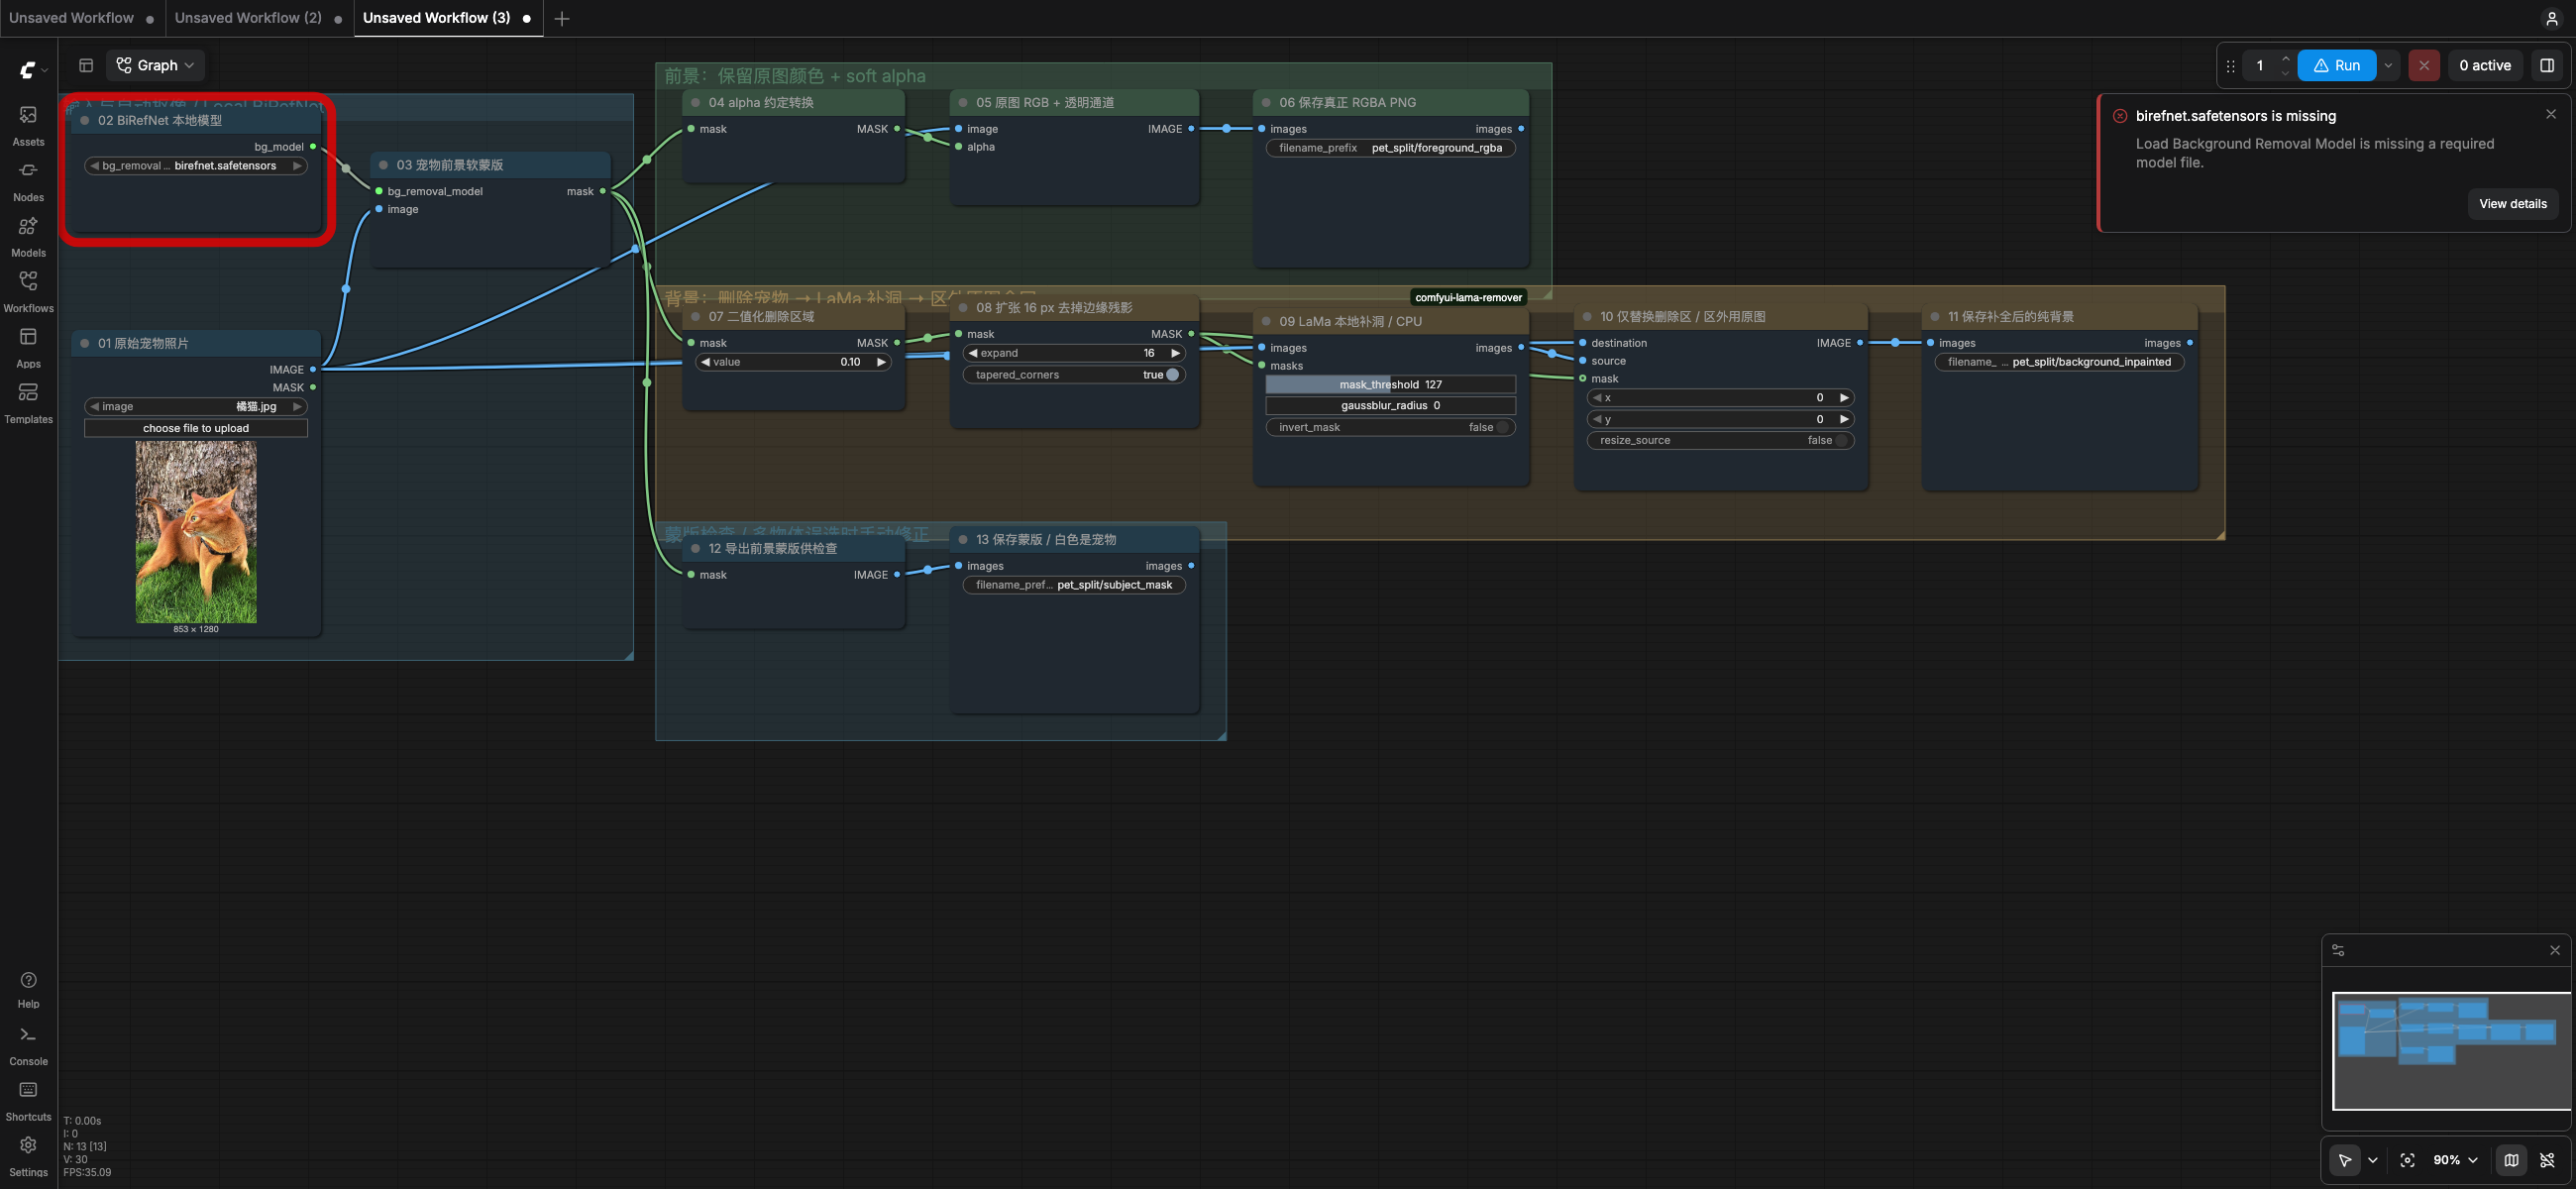
分支 | 复用节点 | 处理与输出 |
|---|---|---|
透明猫 | BiRefNet → InvertMask → JoinImageWithAlpha → SaveImage | 识别主体软蒙版,与原图颜色组合,输出带真实透明通道的 PNG;不重绘已可见的猫。 |
纯环境 | ThresholdMask → GrowMask → LaMa → ImageCompositeMasked → SaveImage | 删除区域向外扩张,补齐猫原来遮住的树皮与草地;仅将补洞区合回原图,保留区外像素。 |
检查与修正 | MaskToImage;手动蒙版修正版工作流 | 导出蒙版检查误选。多宠、牵引绳、草叶干扰时修正选区,再复用同一管线。 |
背景补洞生成的是合理场景,不是找回真实隐藏画面。单纯抠图也不会补出被草挡住的腿爪;这类补全需要单独的局部图像编辑。
部署:使用 ComfyUI 核心 BiRefNet 节点与 LaMa Remover。先下载两份权重,再在本地执行;不需要 API 密钥。本机采用独立 CPU 流程,避免默认假定 Mac MPS 兼容。节点安装、模型路径与参数详见附件 README。
工作流附件:JSON 可直接导入;完整包包含自动版、蒙版修正版、安装说明与 API 备选脚本。
API 备选:本地补洞不理想时,保留本地透明猫,仅把“原图+擦除蒙版”提交给图像编辑接口。先将白色擦除区转换为透明 alpha 蒙版,调用 POST /v1/images/edits 生成不透明背景候选,再检查并局部合回原图。
在附件解压目录准备原图与同尺寸的 erase_mask.png(白色=擦除,黑色=保留),安装 openai、pillow,在本机配置 OPENAI_API_KEY,依次执行:
python3 prepare_api_mask.py assets/橘猫.jpg erase_mask.png
python3 fill_background_api.py
第一条只整理图像与蒙版,并为本例 853×1280 原图同步补边至 864×1280;第二条才发起计费请求,采用 gpt-image-2.5-sunburst、background=opaque、output_format=png。返回后保存背景候选及裁去补边的版本。遮罩只提供编辑引导,仍须检查纹理与对齐。官方接口说明;完整参数与代码见包内《API备选说明》。本轮未调用 API。
|Step 2:荒诞剧本与Prompt
将主体猫图和环境图交给多模态模型,配合下方 Skill 生成荒诞剧本与完整 Prompt。建议使用 GPT 6 Pro。
荒诞剧情:草成精了
猫想咬一口青草,草突然躲开了。然后草反过来变成"小刷子",给猫挠下巴,猫舒服地打起呼噜。
完整Prompt:
10秒,9:16竖屏,24fps,一镜到底。摄影机贴近草尖,从猫嘴侧前方拍极近特写,开场只有鼻尖、胡须、嘴和嘴边的一撮青草;第2秒快速后拉,同时轻微上摇,在0.5秒内拉到低机位中景,露出猫的全身、树根和草坪,带短促motion blur,随后固定这个构图直到结束。
@图片1作为猫的角色与胸背带绑定,保留橘红色短毛、黄绿色眼睛、大耳朵、修长体形和黑色胸背带;@图片2作为环境与材质参考,保留后方粗糙的大树树干、树根和前景浓密青草。
第0秒~2秒,猫伏低身体,鼻尖凑近一撮长草,闻一下,张嘴准备咬住草尖;就在牙齿将要碰到草时,这撮草突然向侧面弯倒,整齐地躲过这一口,猫轻轻咬空,嘴闭住,停顿一下。
第2秒~4秒,镜头快速拉开,猫低着头,视线跟着那撮草移动,又向前探出鼻子;这撮草的根部始终扎在原地,上半段重新竖起,草尖并拢成一把柔软的小刷子,主动伸到猫的下巴底下,左右轻刷两次。猫刚准备再张嘴,动作突然停住,耳朵轻转一下,眼睛仍睁着,保持半秒意外的停顿。
第4秒~7秒,镜头保持低机位同框,草尖继续有节奏地来回挠下巴,接触处的毛发随之轻动;猫慢慢闭上嘴,眼睛逐渐眯起来,重心放低,前爪向前伸展,胸口舒服地伏在草地上,下巴微微抬起,开始发出低而连续的呼噜声。
第7秒~8秒,这撮草停止刷动,轻轻向后收回;猫睁开眼睛,低头看它,停半拍,然后主动把下巴向前递过去,轻碰草尖一次,保持这个等待姿势。
第8秒~10秒,草立刻重新竖起,稍快地继续挠下巴,猫再次眯眼,尾巴尖缓慢摆一下,最后半秒停留在猫享受服务、青草忙着刷动的同框画面。
只有这撮草进行明确的躲避和刷动,周围草叶随微风轻摆,树干始终稳定。
自然日光,树皮纹理、草叶纤维、猫毛和胸背带材质清楚,角色与草地具有统一的受光和接触阴影,写实摄影质感。
Negative:横屏、黑边、切镜、参考图黑底、猫的脸型与胸背带变化、猫说话或露出人类笑容、青草长出五官或人手、草叶变成触手、整片草坪同时跳舞、树干扭动、字幕、贴纸、罐头笑声。
|Step 3:视频生成
使用工具: 即梦 AI - Seedance 2.5 样片模式
输入:
- 参考图1:主体猫
- 参考图2:环境场景
- Prompt:完整剧情描述 + 负面提示词
输出: 10秒竖版视频
效果说明
这个Demo验证了几个关键点:
- 角色一致性:通过单独上传主体参考图,猫的外观在视频中保持稳定
- 环境一致性:通过单独上传环境参考图,树干和草地场景保持一致
- 荒诞剧情:草从"被咬"到"主动挠下巴"的反转,形成完整的情绪弧光
- 用户感知:宠物主人看完会觉得"对对对,我家猫就是这样,被挠下巴就舒服得不行"